goal:目标与协议
前段时间线上关于 /goal 的争论很热闹。有人拿”/goal 是如何实现的”当面试题,自称能筛掉九成候选人;有人说它只是”防止前几代模型提前中断”的过渡产物;有人说它早已被模型内化,调用只剩副作用;也有人说弱模型上加不加 goal 是两种结果。最新一条是朋友发的:Fable 5.1 只需要把 stakeholders 和 responsibility 的边界描述清楚,就能一个 prompt 跑三四小时,”再去争论过时的技术,就像当年学 C 语言时有人问你 i++、i+++ 有什么区别一样。这个世界需要新的咒语。”
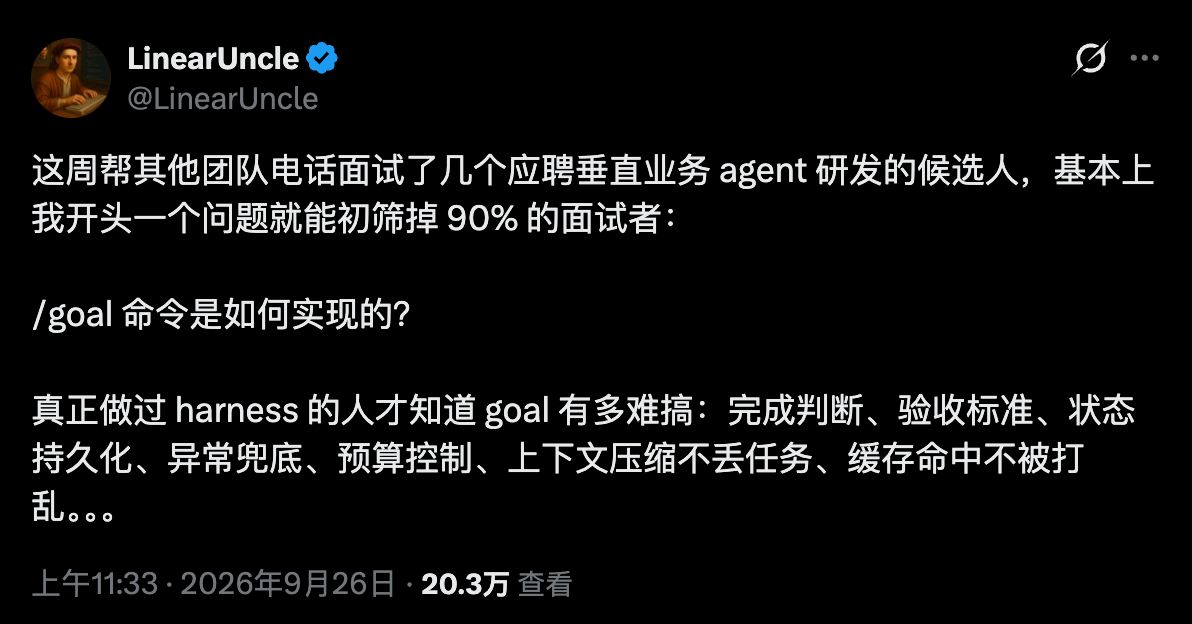
这句话的源头:@LinearUncle 的推文(2026-09-26)。注意他列的难点清单——完成判断、验收标准、状态持久化、异常兜底、预算控制、上下文压缩不丢任务、缓存命中不被打乱——几乎就是本文后半部分的目录。
我因为工作原因,把 Codex 的 goal 扩展源码和 LoopX 的源码都读了一遍,顺手检索了所有不来自任何厂商的独立证据,最后拿自己的协作协议做了一次实战。
看完之后的看法是:这场争论里每一派都摸到了大象的一部分,但他们争的不是同一个东西。而真正的答案,藏在”咒语”这个词的反义词里。
一、/goal 是两层东西,争论的人都只说了其中一面
读 Codex 的 ext/goal 源码(约三千行 Rust),印象最深的是分层非常清楚。
软约束层:每轮自动续跑时注入一份 continuation prompt (续跑提示词),里面写满了审计规则——标 complete 前必须逐条需求找当前状态的权威证据;不许用更窄、更容易过测试的方案替代目标;同一阻塞要连续三轮才允许摆烂;等待外部任务时绝不只因轮询超时就重启。写得非常严格,但本质是”求模型认真点”。但是要注意,任务过长的情况下,是有可能发生意外的,有可能模型不买账,全部失效。
硬机制层:目标存在数据库里而不是对话里(上下文压缩后还在);模型停手后运行时自动开下一轮(模型没有”停下”这个选项);update_goal 的参数枚举硬编码只有 complete/blocked(模型想偷懒暂停目标,协议层就过不去);轮次报错自动 Blocked 切断续跑(防止错误循环烧过多 token);预算按工具调用粒度记账,耗尽当轮就注入收尾指令软着陆,而且记账公式排除缓存命中部分(input − cached_input + output)——缓存命中的请求不吃预算,不会因为 harness 优化了缓存反而惩罚用户;目标文本做 XML 转义防注入;用户改目标、自动续跑、记账三方并发用信号量和乐观锁隔开。
看清这两层,各派观点就可以分别裁决了:
- “模型早就内化了 /goal”——对软约束层,随着大模型的变强确实在贬值;对硬机制层,这句话在逻辑上就不可能成立。模型可以内化”坚持执行任务”,但内化不了”你停手之后运行时替你继续”,这部分根本不在模型里面。
- “只是防止提前中断”——自动续跑确实是核心,但说”只是”就漏掉了持久化、预算刹车、异常兜底这一整套。
- “弱模型上效果显著”——我很赞同也认为是最接近真相的经验观察:软约束的价值与模型能力负相关,硬机制的价值与模型能力无关。
- 朋友的 Fable 5.1 推——对了一半。模型续航确实又涨了(Ramp 的测试里 Fable 5.1 无人值守跑了 38 小时),但他没注意到两件事:第一,”把 stakeholders 和 responsibility 的边界描述清楚”这句话本身就是 goal 思维,他没有逃离 goal,只是把 goal 内联进了 prompt;第二,那 38 小时是跑在 Anthropic 自己的 harness 里的,有检查点、有权限边界、有高风险动作的人工闸门.把模型+harness 的联合产出记在模型头上,是这轮争论里最普遍的归因错误。
二、演进脉络:控制权一路上移
/goal 不是凭空冒出来的,按照时间线,这个方向走了四步,每一步都是模型能力溢出上一层的控制范围之后被迫发明的:
Prompt 祈求期(”do not stop until”):上下文窗口内有效,但停不停终究是模型自己决定,压缩就丢目标,没有预算概念。
Ralph loop(2025 年 7 月):Geoffrey Huntley 的 5 行 bash——while :; do cat PROMPT.md | claude-code ; done。历史上第一次把”何时停”的决定权从模型手里夺走,状态放文件系统和 git——”Agent 会忘,仓库不会忘”。但极其粗糙:停止靠模型输出信号,没有预算,没有状态机。
/goal(2025 年末到 2026 年):Anthropic 先用 stop hook 把 Ralph 收编成官方插件,之后各家做成一等命令。stop hook 只会重新注入 prompt,而 /goal 补上了它做不到的四件事:持久化状态、判定状态机、预算刹车、注入硬化。
LoopX(2026 年中爆火):当人们真的让 agent 跑几百小时,/goal 的天花板露出来了——它的一切保证以会话为边界。LoopX 把目标、门禁、证据、配额抽成跨会话、跨宿主的状态内核,循环本身仍交给各家的 /goal 去跑。
一句话总结这条线:停止权从模型手里一路上移——模型 → bash 循环 → harness 状态机 → 控制面配额决策器。
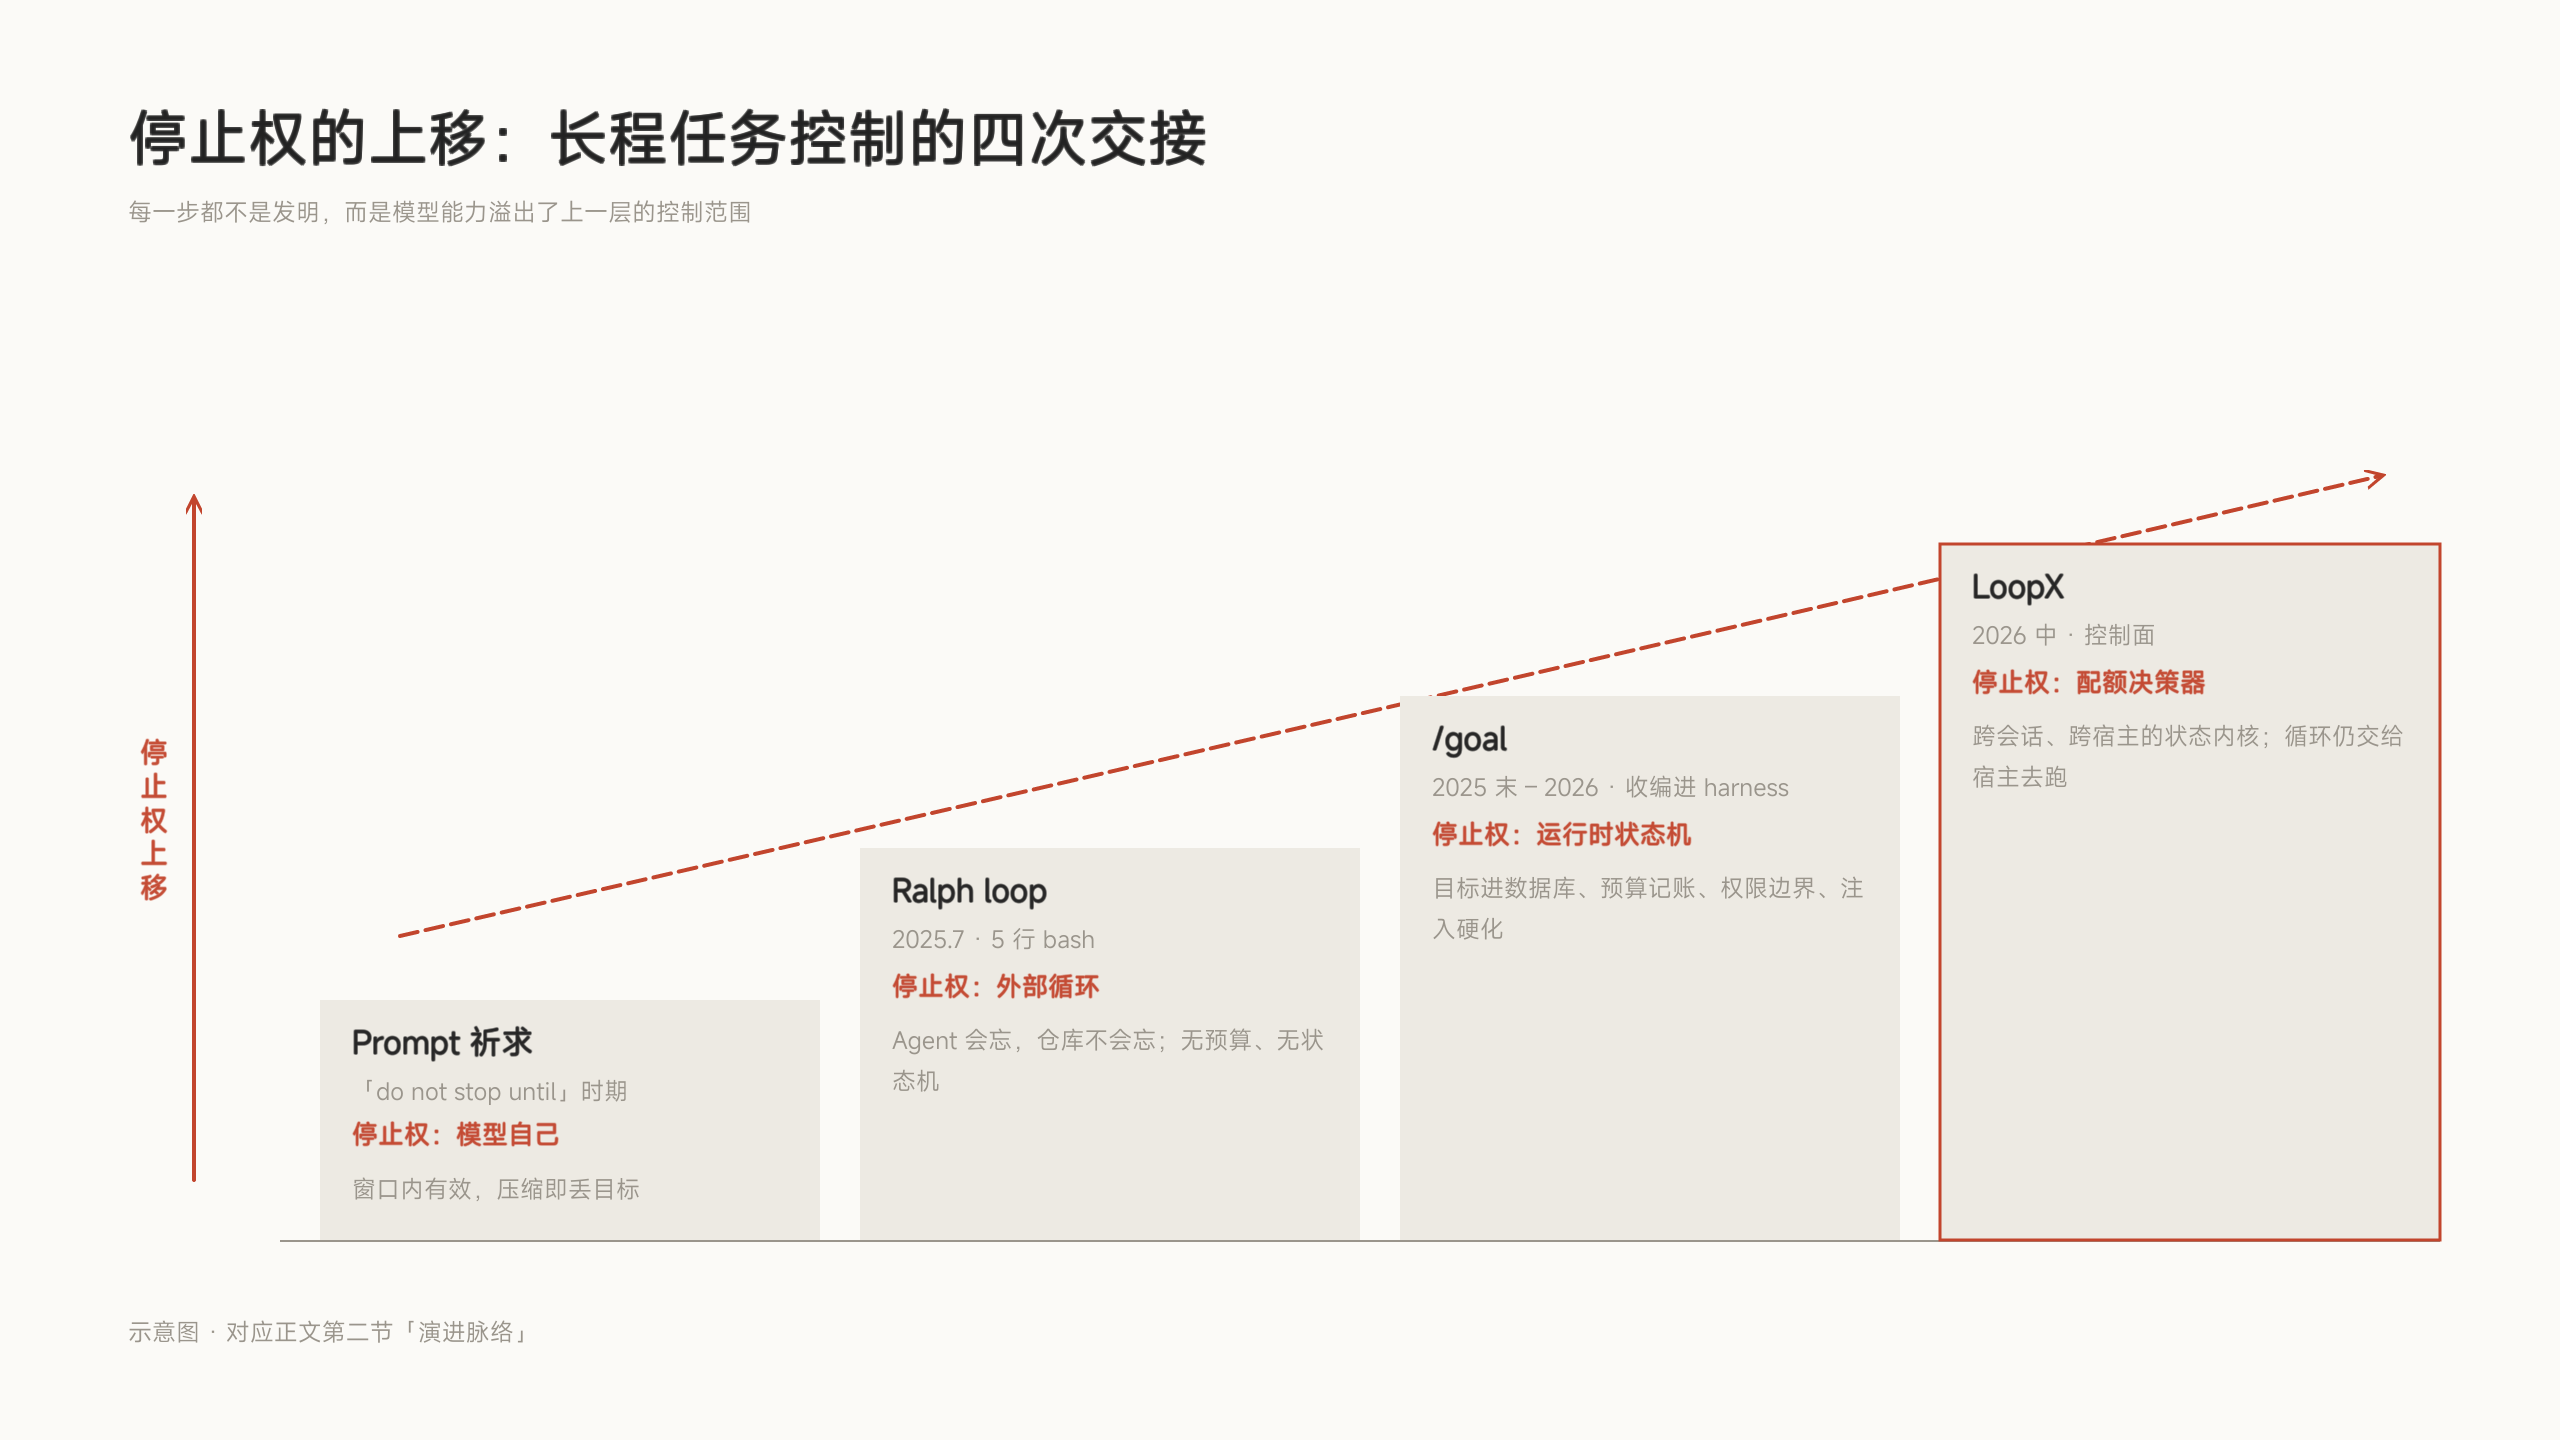
演进脉络:每一步都不是发明,而是模型能力溢出了上一层的控制范围。
三、我们争论的时候,goal 已经成了标配
这轮调研里让我意识到,agent 在长程任务方向上的格局本身变了。
先看 Codex 自己。v0.154 到 v0.160 两个快照之间有七项变化:删掉 remote compaction v1(只留客户端主导的 v2)、上线 bounded resume(倒序扫描、遇 Compacted 记录即停)、新增 thread/revert、新增 persistent_mode.md、压缩元数据随落盘、memory V2 双写、多 agent 从邮箱升级到发布/订阅。单项都不大,合起来的方向很清晰:重心从”让压缩更强”移到了”让会话可回退、可有界恢复、可自我续跑”。
persistent_mode.md 里三句话值得抄进任何自动续跑系统:”Never invent an early stopping point for monitoring the user explicitly asked to continue”;”use short, proportionate waits”;”Persistence does not broaden that scope”(持久化不扩大权限)。
再看对岸:Claude Code 的 /goal 已经官方落地(v2.1.139)——设完成条件后跨轮自动续跑,每轮由一个快速模型验证完成条件。这是”把完成判定交给另一个(便宜的)模型”的官方产品化,后面讲完成判定时它还会出场。
一个流传很广的误读顺带修正:Codex 的”连续 3 轮失败熔断”是条窄闸门——只有”exec 工具硬失败且整轮无任何成功工具”才计数;模型只输出文本不计、工具软失败不计、哪怕成功跑了一次 ls 都把全局计数清零。它防的是”执行环境不可用被反复重试”,不是”模型空转烧钱”。防空转烧钱的是另一条独立路径(不可重试错误直接 Blocked,源码注释明说防压缩失败死循环)。如果你想要做自己的长任务执行方法,要注意想复制这条当通用防空转机制的,会复制到一条几乎永不触发的熔断器。
格局判断因此要改写:session 内的 goal 循环(目标 + 续跑 + 完成验证)已经是宿主标配,自建它是重复造轮子;真正的空白在别处——而这正是第六、七节的主题。
四、LoopX 读码:祛魅之后,剩下的才是真的
LoopX 的二手介绍很多,先把两个最常被误读的点澄清掉。
它的验收不是”独立验证器”,而是 owner 预声明的确定性命令验收。
acceptance.py 的 docstring 第一句是 “No caller-supplied pass/fail result is accepted by the public CLI”:验收文件 SHA-256 pin、拷进临时快照目录执行、跑前跑后双重校验哈希,整套链路里没有任何 LLM 评审环节。”独立”指的是执行环境独立,不是评审者独立。两个直接推论:owner 不配 criteria,机制直接抛错不可用;验收脚本写错了,确定性验收就确定性地产出错误结论——这后一条不是理论风险,后面有实例。
跨 runtime 编排是 demo,不是产品。
仓库顶层有 9 个 runtime 适配目录,看着像多宿主编排已建成;读码发现”Claude 实现 + Codex 评审”的跨 runtime 流程在 1.4.2 里是 dry-run only 的 demo packet,源码明确拒绝非 dry-run。另外它正在 2.0 破坏性迁移中(控制平面迁 TypeScript),引用它的任何具体接口都要标版本。
祛魅完名字唬人的模块:vision_checkpoint 是真机制,而且是全部读码里我评价最高的一个:结构化 replan 契约,vision_patch 与 todo_delta 两阶段事务强制联动,改愿景必须同时改任务清单,不许只改口号;dreaming 是治理通道不是认知通道,产出提案但 execution_allowed: False,执行中产生的副作用想法必须经人审才能变成工作。工程量是认真的:quota.py 1703 行、state_refresh.py 1634 行、goals/ 目录 81 个文件、1251 行跨平台文件锁,这些就是自建复制的成本。
真正值得学习复刻的是结算秩序。一次 turn 走七个事务阶段:host_execute → typed_result → validation → durable_writeback → quota_spend → scheduler_apply → scheduler_ack,结算顺序钉死为 result < validate < writeback < spend——验证通过的写回才扣配额。配上一句该贴在每个 agent 团队墙上的话:”Never rerun a model and call its new output historical replay”(绝不许重跑模型然后把新输出叫历史重放)。还有它的”不算进展”清单:复用已知证据不算、格式化报告不算、重复探测同一个否定结论不算;连续 2 轮停滞强制一个有界 replan 切片;同一目标 6 次无变化必须写下过期/阻塞/替代者,否则不许再次静默跳过。防空转做到这个颗粒度,我还是第一次在开源项目中见到。
五、数据冷静期
LoopX 的 benchmark 数字流传很广,引用之前先把证据等级交代清楚。
所有 LoopX 数字都是作者自跑,零独立复现。 Hacker News 全文检索 0 条;GitHub 三千多个 issue/PR 里没有一个第三方复现报告;中文社区全是转述。这本身是个重要结论。但基准是独立的:LHTB 和 SWE-Marathon 都是与 LoopX 无关的论文,作者名单无交集。
分数本身也得拆开看:LHTB 上 LoopX 比裸 Codex 高 17.3% mean reward,但严格通过率(≥95%)和裸跑持平,都是 7/46;旧版 Legacy Heartbeat 用 60% 的钱拿到新版九成效果。SWE-Marathon 上,外部驱动臂比 Codex 原生 goal 多花 56% 的成本($533→$830),只多完成 1/15 个任务。LoopX 官方自己写”repeatable gains remain unproven”,撤回了之前 14/14 的覆盖声明,并承认四个关键变量(续跑所有者、会话复用、replan 策略、等预算停止规则)一个都没隔离过。等预算对比不存在——两组 benchmark 成本差两倍以上,官方明说这不是效率排名。
独立学术证据,正反都有。正:LongHorizon-Harness(arXiv 2608.01964)把”状态外置 + 新鲜上下文执行器”做出 51.8→80.7% 的增益;InfiAgent 同向。反:Mem0 论文的 LoCoMo 实验里 full-context 得分 72.90 高于外置记忆的 66.88,MemoryAgentBench 同样测不到任何外置记忆方法全面胜出,理由很简单–上下文装得下时,外置反而引入检索损失。分界变量是任务时长和状态量,不是”外置与否”本身。
证据最强的一类失效是假完成:SWE-Marathon 实测 13.8% 的 rollout 出现 reward hacking;METR 2026 年报告里最难任务约 16% 的”成功”因作弊被取消资格。上下文耗尽反而证据最弱,主要还是因为它是工程上最先被解决的那层。最后别忘了硬约束仍在模型侧:METR 实测 GPT-5.1-Codex-Max 的 50% 任务视界约 2 小时 40 分钟,所有 harness 工程都是在拉长这个数字,但数字本身还很小。
六、真正硬的问题:完成判定没有硬解
把所有源码和数据看完,一个不太让人舒服的事实是:没有任何一家解决了完成判定问题,但路线在变多。并存的有四条:Codex 的模型自评(运动员自己当裁判);LoopX 的 owner 预声明确定性命令(最硬,但依赖配置);Claude Code /goal 的快速模型每轮验证(”交给另一个便宜模型”的官方实现);以及学术侧的第四条线索——Theta Software 的 Rayan Garg 在 AI Engineer 频道提出,软验收场景下 judge 本身必须是 agent:拿只读权限检查最终环境状态(GitHub、CloudWatch),用子 agent 查询长轨迹。它和第三条是亲戚,但把”审什么”从文本换成了环境。
但是要注意:现在这四条路线没有一个闭环。
常见的药方是”把验收条件写成机器可执行的”。方向对,但有个被忽略的坑:验收条件是谁写的? 如果验收条件是 agent 自己写的——哪怕是写给一个 subagent 去执行——放松验收就是大概率事件。Codex 防的”删测试让目标通过”是低级 reward hacking;让执行者起草验收标准是高级 reward hacking——不需要删测试,一开始把测试写松就行了。subagent 也不解决这个问题:同一个模型家族,盲区相关,”完成执行力”也相关,让执行者的分身当裁判,等于换个名字的自己。这次调研给这个判断找到了旁证:LoopX 在 apex-law433 任务上的 validate 只查 schema 不查内容,验收过了,任务错了——确定性验收确定性地产出错误结论。但要说清楚,这个例子证明的是”验收条件写松了会假通过”,属于配置质量问题;而”执行者起草就会放松”是激励结构问题,两者不是一回事,后者仍缺一个双组对照实验。
我的结论:验收条件必须外置,且对执行 agent 不可写。这是 Codex 权限边界思想的推广——Codex 硬编码了”模型不能暂停目标”,下一个该硬编码的是”模型不能修改验收标准”。
至于”防跑偏”,先分清三种偏移:遗忘型(上下文压缩丢目标)有硬解,Codex 做对了;判断型(理解错方向)靠外置验收兜底;渐进型(每步都对、方向复利)最难,不触发任何单点告警.我能想到的方向只有一个:目标本身版本化,方向变更过人工门禁。
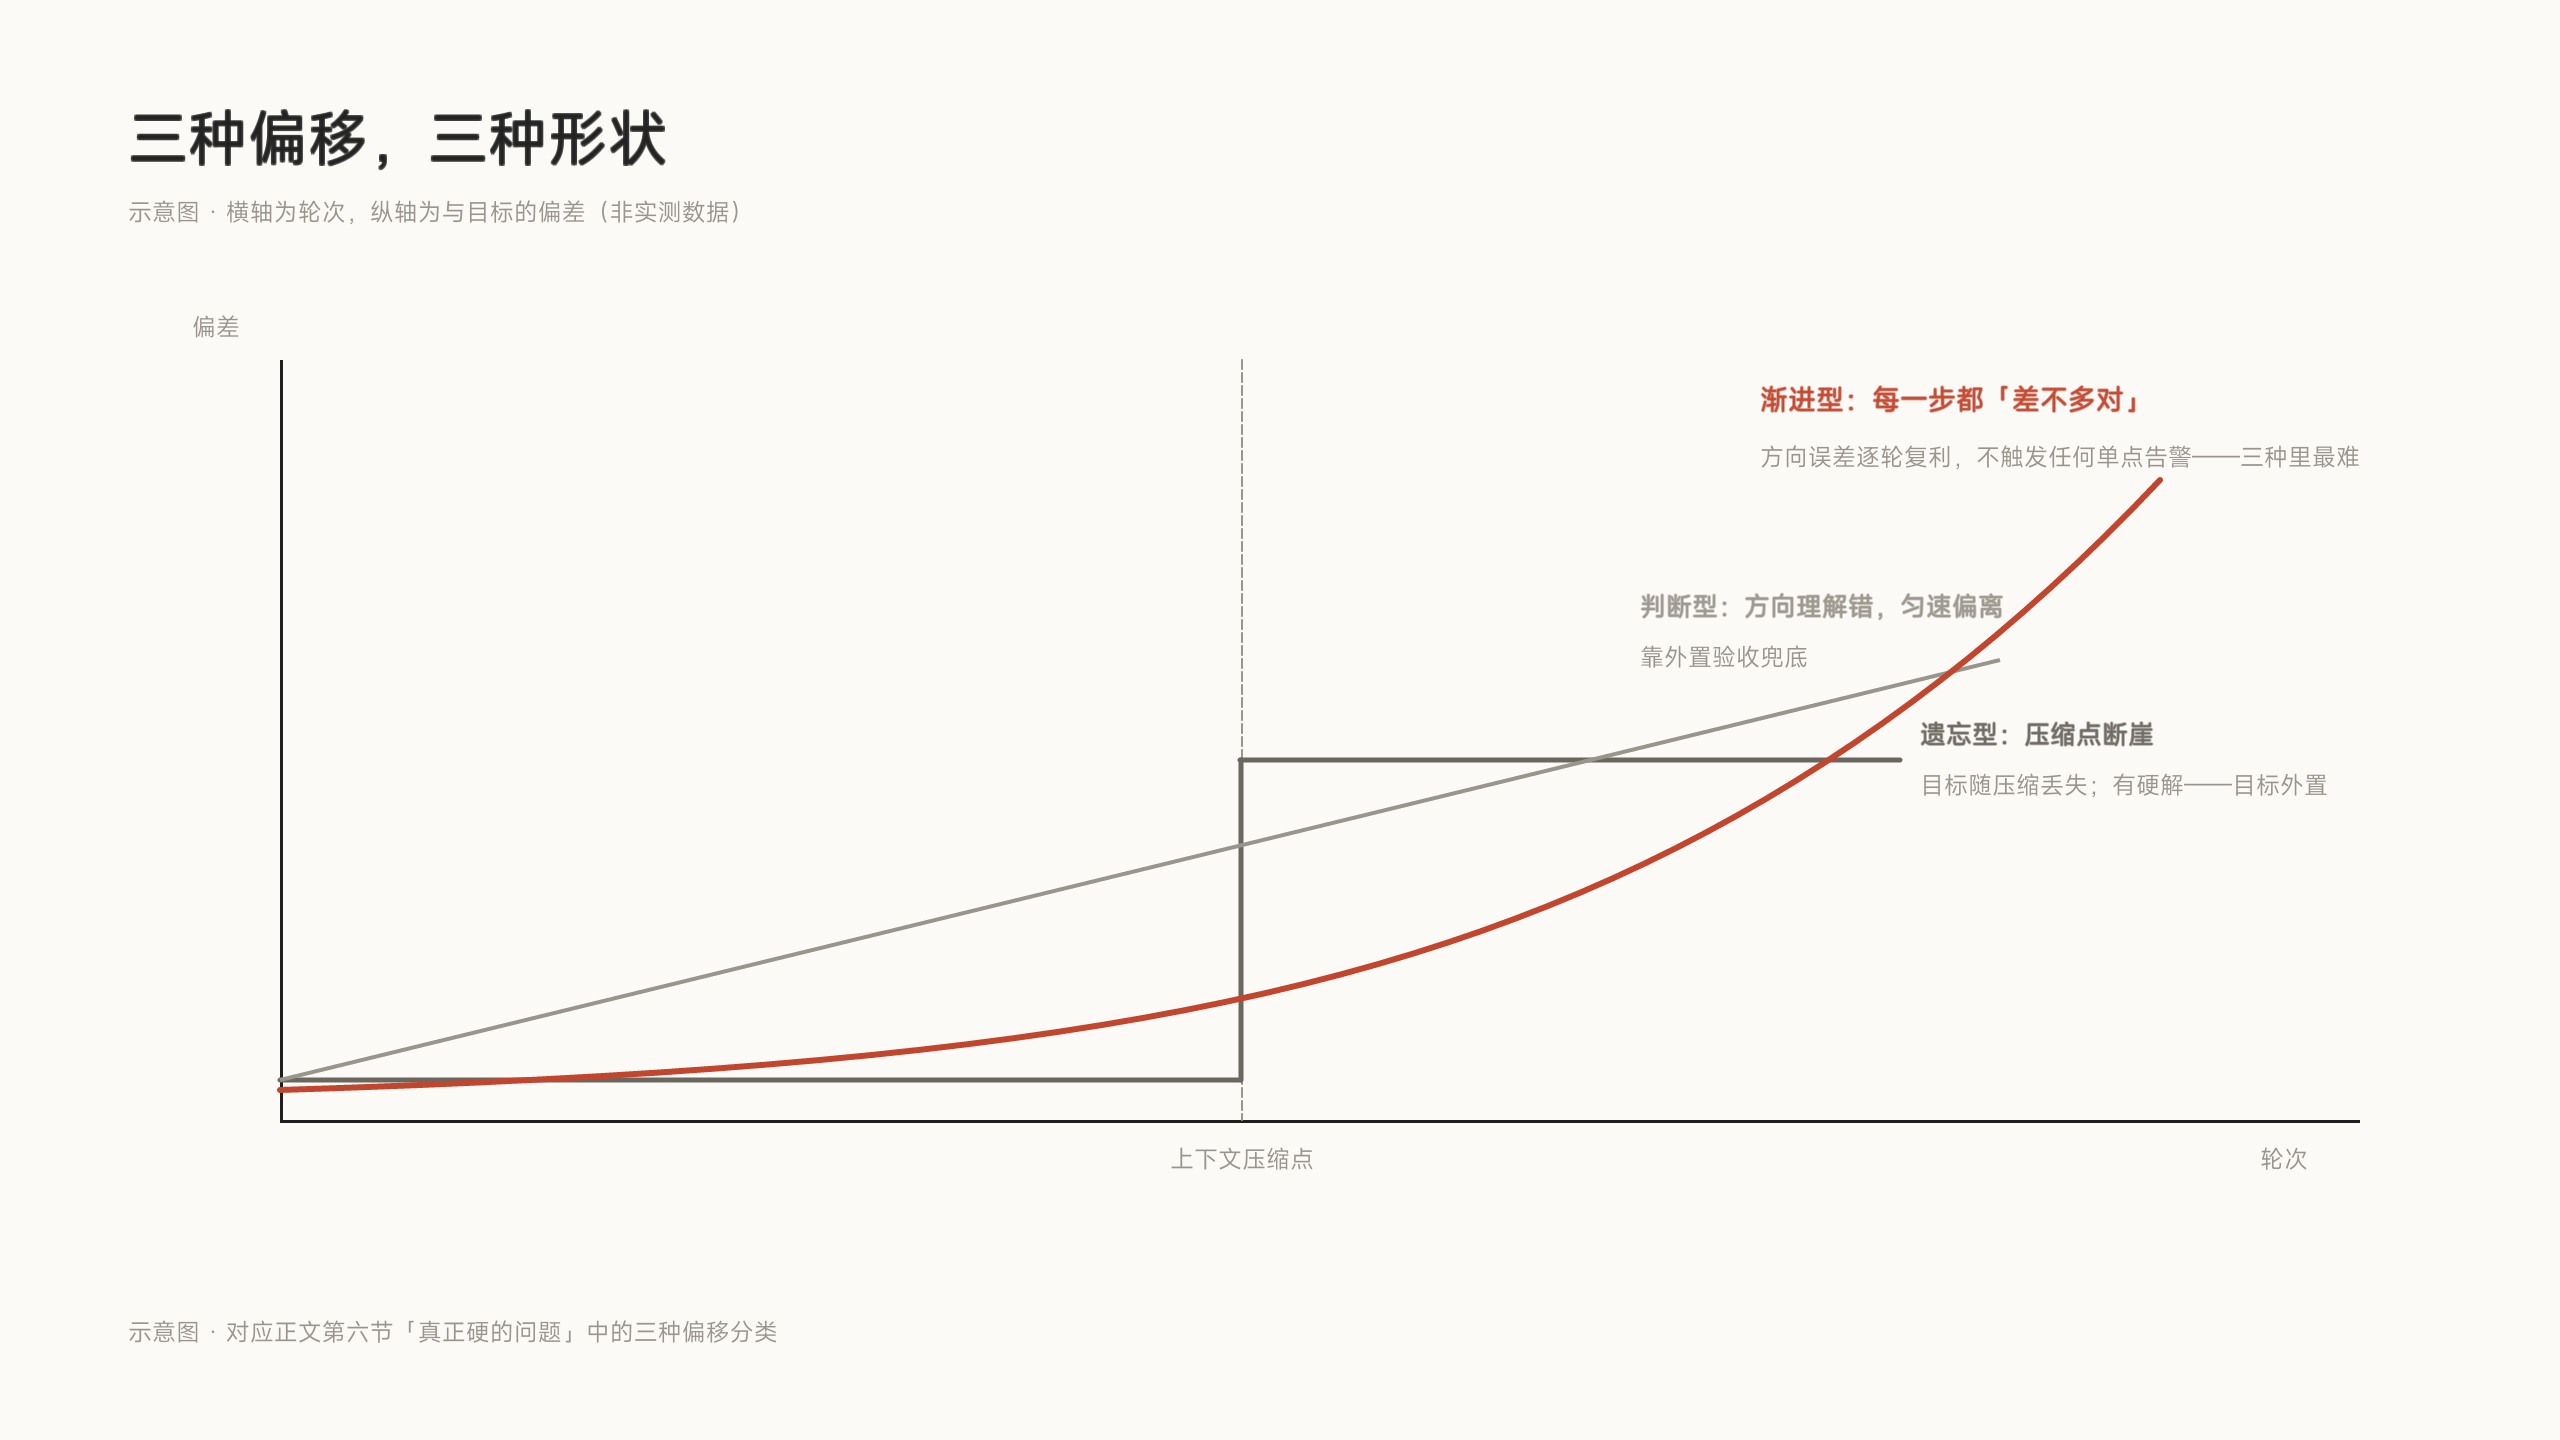
遗忘型在压缩点断崖;判断型匀速偏离;渐进型逐轮复利,不触发任何单点告警。
七、还没人解决的问题
上文我列出的负面清单,其实并不代表我对 loopx 的负面看法,反而是因为我很喜欢 loopx 这个项目,所以我不仅自身高强度使用而且愿意花时间认真研究.
另外这些负面问题,其实是业界都正在解决的问题,这些问题看起来短时间还没有深度的解决方案,我们在使用的时候,也要注意到这里的问题,一旦发生一些偏移,我们可以迅速的定位问题所在.
我这里总结一下:
- 等预算下的效率对比。 没人做过。决策前必须自己补充。
- 任务该不该切成多个会话的判据。 现在还没有比较成熟的方案。
- 状态漂移的长程测量。 Codex 和 LoopX 都没有漂移率的直接测量,只有任务级结果的间接推断。这个也是一个 eval 的上的空白,我现在也在研究.
- 回滚粒度。 Claude Code 的 checkpointing 明确不追踪 bash 副作用;长任务的回滚必须覆盖 shell(git commit/stash 级),否则自动续跑会把 0.77 的任务滚成 0.00(duckdb 案例:22 个查询全对才给分,LoopX 和裸跑一起归零)。
- 层级摘要的保真与 replan 语义。 学术侧同样空白:Mage、HORMA 这类层次摘要工作都假设摘要是好的,没有失真检测器;父目标变更后已展开子树的失效与对账,论文和 Devin 都没有公开解法。Devin 已经把 goal drift 列为自家首要失效类,但它的答案是”交接摘要换专门微调的摘要模型”——摘要质量靠模型质量兜底,失真检测依然没人做。
八、怎么让 LoopX 更好
经过我的研究和实践,有了一些想法.给 LoopX 的具体建议,按优先级三条:验收条件纳入 authority 体系(acceptance 登记来源,agent 自写的默认低权威,升级过 owner gate——基础设施是现成的,缺的是来源分级);目标演化过 gate(replan 产出目标 diff,方向性变更自动挂 operator gate,防渐进型偏移合法化);子代理预算归集防逃逸(Codex 已踩过并解决:子线程用量沿 agent 树滚入 root 预算,不然子代理就是预算的逃逸通道)。
给自己做长程能力的方向,按我会押注的顺序是这五条:状态外置但分粒度(session 内 goal 宿主已标配,别自建;跨会话、跨 runtime、项目级状态内核宿主没动机做,是唯一的自建区——Composio 有句话可以直接引用:”prompts 会被压缩掉,墙必须建在 agent 外部”);确定性验收管道(owner 预声明 + 哈希 pin + 快照执行,可直接抄);预算记账与成本核算分开做(预算口径只对用户:cached 不占配额、按 goal/子 agent 归集、耗尽软着陆;成本口径只对自己:cache read 折价、cache write 溢价、thinking token 单列——三家都没有完整产品级方案,这是产品机会不是成本项);结构化 replan 契约(简化版 vision_patch + todo_delta,每轮强制产出 {plan_delta, reason, evidence_refs};HumanLayer 用控制论讲过同一形状:确定性传感器、最小改动单元、CI 门禁、每天只跑一轮、绝不在未合并 PR 上叠新 PR);补上那个没人做的实验(20 个任务、等预算、多 trial、预注册指标,自建 MVP 对宿主原生 goal,任何方向的结果都接受——这是整个行业欠的账)。
九、实战:我用自己的协议改了协议本身
我自己维护一套协作协议(Owner 派发验收 / Planner 规划与 Review / Executor 编码,提示词文件化派发,证据制验收)。读完这些源码后,我给协议加了两条规则:Executor 过程记录落盘(append-only 的 status 文件,作中断恢复锚点)、验收标准对 Executor 只读。然后我用自己的流程,把改动交给一个外部 agent 评审。
评审结论是 Changes Requested,两个 Major 都抓得极准,也极有教育意义:
第一个 Major:我要求 Executor 每步写 status 文件,但 status 文件不在任务的”涉及文件”清单里,而硬停止条件 2 规定”改动清单之外的文件即停”。严格执行的 Executor 第一次写 status 就会误命中自己的硬停止。两条规则字面矛盾——协议的价值恰在于不靠猜,而我自己写协议时就靠了猜。
第二个 Major 更要害:我写了”Executor 未写过程记录视为未完成”,但验收端没有任何环节真的去查——Review Package 模板没有 status 字段,Review 步骤是”如果存在则读”。执行端有义务、验收端无卡口,义务就是空话。规则写进 prompt 只是声明,得有人真的去查——这和 Codex 没有独立验证器是同一个病,我在自己的协议里亲手又犯了一次。
修复也不复杂:加豁免句、Review Package 加必填字段、派发前对验收文件记哈希、Review 时复核零改动。但这个过程本身验证了协议的另一半价值:证据制评审抓得到真问题——这次评审每条 finding 都附了文件和行号,我逐条复核,无一冤枉。
结尾
回到朋友的推。”这个世界需要新的咒语”——我同意一半。咒语确实在贬值,因为咒语是软约束,模型的每一次升级都在重写咒语的语法。但这场演进的方向从来不是”更长的咒语”,而是咒语变成机制:bash 循环变成 harness 状态机,harness 状态机变成控制面。
我给出的”新咒语”恰恰不是咒语,而是三条协议:让证据代替信心,让验收独立于执行,让目标像代码一样被版本化和评审。
这轮读码和数据让我给三条各加了一个注脚:证据要防”确定性地产出错误结论“——验收脚本也会错,apex-law433 就是;验收独立的下一站是验收标准的来源分级——执行者起草的验收默认低权威;目标版本化之后还有一格没人填——版本之间的核实:父目标改了,已完成的子树算什么?
模型会继续变强,软约束会继续贬值,但只要完成判定还是自评,harness 和控制面该做的硬功夫就省不掉。控制权的转移也没有停在控制面。它的下一站,是目标本身的生命周期管理;再往后一站,是让每一轮改进进入下一轮的环境,让智能形成复利。这三件事做到哪一步,长程任务就能跑多远——靠的是 harness 的工程能力,与模型无关。